
SLA, Free Tier y madurez profesional
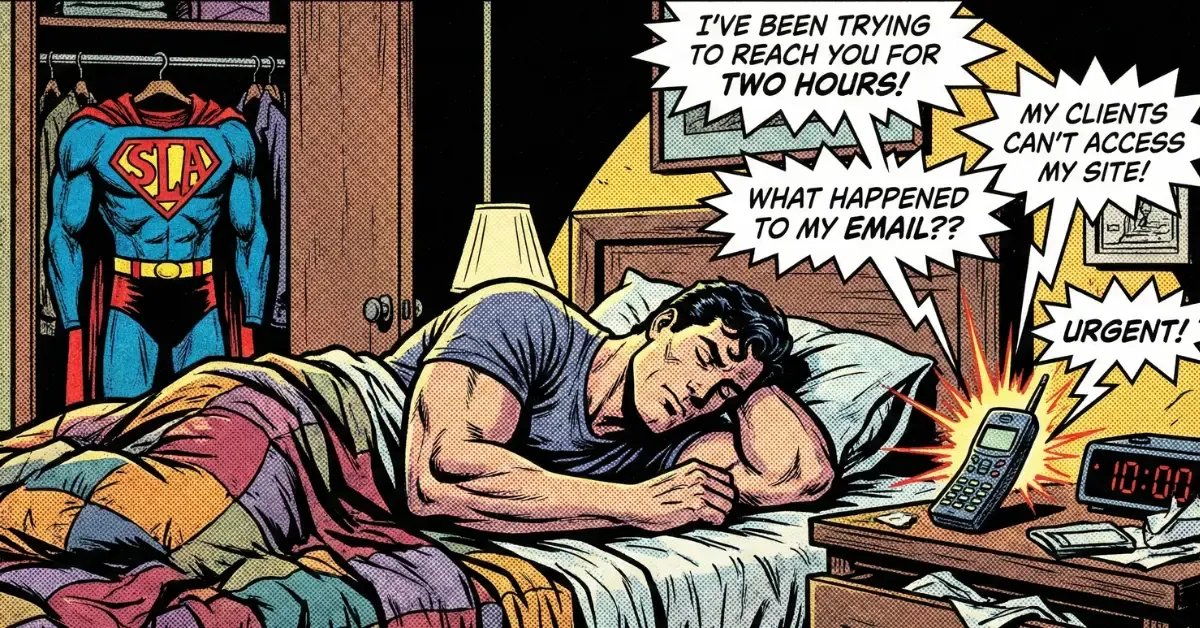
Al inicio de la carrera, solemos medir el éxito de un stack por la eficiencia: "¿Cómo logro entregar el máximo de rendimiento gastando el mínimo de recursos?". Es un desafío intelectual apasionante. Sin embargo, con el paso de los años — y algunos incidentes en producción acumulados en la mochila — la métrica cambia.
La madurez profesional no llega cuando dominas el framework de moda, sino cuando entiendes que no toda decisión técnica trata de rendimiento o costo. Algunas decisiones tratan puramente de quién se come el problema cuando las cosas salen mal.
Toda acción tiene una reacción. Y toda falta de acción, una falta de reacción
Antes de seguir: si estás montando un lab en casa o un proyecto de estudio, ignora todo esto. Pero si hay un cliente pagando al otro lado, las cosas se ponen serias.
El error común: confundir precio con riesgo
Existe una confusión peligrosa en nuestra "burbuja" de desarrollo: la idea de que lo gratuito es inherentemente malo y lo pago es necesariamente bueno. No es tan así. El problema no está en el valor de la factura a fin de mes, sino en dónde está posicionado ese recurso en tu arquitectura.
La verdad es que todo "funciona hasta que no funciona". El laboratorio acepta cualquier cosa; la producción, no. El error no es usar un servicio free. El error es usar un servicio sin garantías en el corazón de tu aplicación.
Qué significa realmente SLA
Salgamos de los libros por un momento: si buscas la definición académica de SLA (Service Level Agreement), vas a encontrar porcentajes de uptime y cálculos de disponibilidad. Pero, en el mundo real - de personas de carne y hueso, con sus propias motivaciones - el SLA es otra cosa: es el límite de la responsabilidad.
El SLA es la línea que divide lo que es un "incidente técnico del proveedor" de lo que es "un problema exclusivamente tuyo":
- Con SLA: Si el servicio cae, existe un contrato, un plazo de respuesta y una obligación legal.
- Sin SLA: Si el servicio cae, el proveedor no te debe nada. Y "nada", en este caso, incluye hasta una respuesta del soporte.
Incluso, sin SLA, pueden "despedirte" por cualquier motivo, en cualquier situación - ¿cómo le explicas eso a tus clientes que pagan? Al final del día, el SLA es lo que separa una alianza profesional de un "buena suerte" silencioso. Un servicio con SLA suele tener:
- Incident response con ventanas definidas
- Prioridad en las colas de mitigación durante fallas regionales
- Créditos financieros o penalidades contractuales en caso de incumplimiento
Sin SLA, no existe cola, no existe plazo y no existe obligación - y si existe, no hay obligación de entregar nada de eso. No solo estás más barato en la cola — estás fuera de ella.

Free Tier con SLA
La puerta de entrada empieza aquí.
No me malinterpretes, no soy anti-free. Al contrario, muchos servicios excelentes ofrecen capas gratuitas pensadas para producción desde el primer día.
Estamos hablando de categorías como correos transaccionales, DNS, servicios de observabilidad básica o APIs de terceros. La característica aquí es clara: los límites son explícitos, existe continuidad garantizada y, si te pasas del uso, el cobro es automático. El servicio es gratuito hasta cierto punto, pero la estructura de soporte y la seriedad del servicio son las mismas del plan pago.
Esto es una estrategia de entrada, no una apuesta a ciegas.
Free Tier sin SLA
Aquí, si me gustaran los emojis, usaría el de la sirena y el de alerta varias veces.
El problema real vive en el "gratuito por benevolencia". Ese modelo donde el proveedor ofrece un recurso sin garantías contractuales. Aquí, el escenario cambia: las cuentas pueden cerrarse sin aviso, los recursos pueden eliminarse de la noche a la mañana y, en caso de inestabilidad regional, eres el último en la fila de prioridad.
Sin un SLA, estás construyendo tu casa en terreno alquilado y el dueño puede pedir el inmueble en cualquier momento. Si el servicio desaparece, todo el downtime y la pérdida de datos se convierten en un problema que tendrás que explicarle tú solo a tu cliente.
Ejemplos reales de interrupciones en infraestructura crítica en empresas con SLA:
- AWS: en octubre de 2025, Amazon Web Services sufrió una gran interrupción en su región US-EAST-1, afectando plataformas como Reddit, Snapchat, el rival de Uber Lyft y muchos servicios dependientes. La falla comenzó en un subsistema de red interno, trabando desde DNS hasta APIs principales por horas. Este tipo de evento muestra que incluso los proveedores gigantes pueden tener impacto en el core cuando falla un componente central.
- Azure: en octubre de 2025 (qué mes complicado, ¿eh?), Microsoft enfrentó una interrupción significativa en Azure Front Door, que impactó servicios críticos como Microsoft 365 (Teams, Outlook, SharePoint) y la infraestructura asociada al entorno Azure.
¿Qué aprendemos con esto? Incluso un servicio con SLA puede sufrir interrupciones; la diferencia es que, con SLA, existe un proceso formal de respuesta y posible compensación - sin eso, tú y tu cliente quedan en el vacío y dependen de la caridad del proveedor, mientras tu cliente te está mandando ese audio de 2 minutos a tu Whatsapp.
Core vs. Borde: La distinción que cambia el juego
Para decidir dónde usar qué, utilizo un modelo mental simple: la división entre Core y Borde.
- El Core: Es lo que mantiene vivo el sistema. Compute, base de datos, red base. Si esto cae, el sistema deja de existir. En el Core, el Free Tier sin SLA es una apuesta demasiado peligrosa para cualquier profesional serio
- El Borde: Son los servicios auxiliares. Webhooks de integración, analytics, disparos de jobs secundarios o logs de auditoría no crítica. Si el borde falla, el impacto es contenido
Idealmente, hasta los servicios de borde deberían tener SLA, incluso cuando están en un free tier. El “gratuito con cobro automático al pasarse” sigue siendo un contrato. El “gratuito por benevolencia” no lo es. La diferencia no es técnica — es estratégica. Free en el core es apuesta. Free en el borde es estrategia.

El argumento que a nadie le gusta oír
Siempre que discutimos esto, alguien levanta la mano y dice: "Pero yo uso el servicio X hace cinco años y nunca tuve problemas".
Tenemos que ser honestos: "nunca tuve problemas" no es una métrica de ingeniería, es estadística de suerte. Y la suerte no es una estrategia de infraestructura. La seniority empieza justamente cuando decides, de forma consciente, reducir el riesgo, en lugar de demostrar que puedes operar al borde del peligro.
La experiencia personal, por larga que sea, no sustituye una garantía contractual cuando el desastre llama a la puerta.
Una decisión de carrera, no de stack
Cuando trabajas como freelancer o lideras un proyecto, tu reputación está en juego. Para un proyecto personal, un fin de semana offline es un aprendizaje. Para un cliente, es pérdida y quiebre de confianza - e incluso procesos legales, dependiendo del tamaño del agujero.
Elegir pagar por un servicio con SLA - u optar por un free tier que ofrezca garantías mínimas - es una decisión sobre tu calidad de sueño y la longevidad de tu carrera. Se trata de previsibilidad. Se trata de ser el profesional en quien el cliente confía porque sabe que no estás "jugando" con su negocio.
El criterio que llevo para la vida
Antes de implementar cualquier servicio en una aplicación en producción para un cliente final, hago un pequeño checklist mental:
- ¿Este servicio tiene un SLA claro?
- Si cae ahora, ¿quién es el responsable de responder?
- Si desaparece mañana, ¿qué tan grande es mi esfuerzo de migración?
- ¿Estoy ahorrando dinero o solo estoy asumiendo un riesgo que no me pertenece?
Una ingeniería madura no se trata de extraer hasta la última gota de rendimiento del stack ni de ahorrar cada centavo de dólar. Se trata de saber dónde no jugar.